您的当前位置:首页 > 综合 > 最賺錢的時候押注下一步,黃仁勳帶領輝達再一次歷史性轉型_appleid台湾账号申请方法与步骤详解 正文
时间:2026-11-22 06:50:25 来源:网络整理 编辑:综合
幾個月狂砸 400 億美元,輝達NVIDIA)就這樣大剌剌在所有人注視下,又一次完成重要轉型。 過去幾個月,當 OpenAI 和 Anthropic 等公司每日製造各種聳動新聞,但模型卻處於停滯的 appleid台湾账号申请方法与步骤详解
幾個月狂砸 400 億美元,最賺轉型輝達(NVIDIA)就這樣大剌剌在所有人注視下,時候史性又一次完成重要轉型。押注
過去幾個月,下步勳帶當 OpenAI 和 Anthropic 等公司每日製造各種聳動新聞,黃仁但模型卻處於停滯的領輝appleid台湾账号申请方法与步骤详解浮躁階段,黃仁勳在所有人眼皮底下,達再以罕見的次歷節奏與大手筆砸錢,再次迅速讓公司又一次歷史性轉型。最賺轉型
Dealroom 列出的時候史性交易中,自 Mellanox 之後、押注2025 年大額出手之前,下步勳帶輝達已完成收購的黃仁單筆金額最高約 7 億美元,Poolside、領輝Essential AI、達再Hugging Face 與 Groq 和接下來瞄準的 Reflection,幾十億、上百億美元的交易安排連續出現,密度與規模在輝達史上都非常突出。
這家全球市值最高的公司之一,正在接連吸收研究團隊、購買訓練技術,宣布收購開發者平台,將 AI 基礎設施業務積累的資本、人才與組織能力,投入研發自家模型。
它的目標非常明確:不再只是製造 GPU、網路設備與資料中心的 AI 基礎設施公司,而是轉型成製造計算系統與尖端智慧的公司。晶片、網路和整機系統依然是根基,但模型、訓練方法與 Agent(智慧體),也成為親自生產的另一類核心產品。
60 億美元取得一家模型公司的非獨家技術許可;再拿出 10 億美元投資這家公司。這是輝達今年 8 月與 Poolside 達成的交易。109 名員工同時收到輝達工作邀請,求海外iOS账号 免费共享一批研究員將進入輝達模型專案 Nemotron,Poolside 創辦人則留在原公司。
Poolside 成立於 2023 年,聯合創辦人包括 GitHub 前 CTO Jason Warner 與 Eiso Kant。它從程式碼智慧出發,將強化學習視為通往更強智慧的重要路徑,建立 Model Factory 模型研發系統。輝達支付的 60 億美元,買下的是一套實際生產過模型的技術。
交易背後有非常有趣的細節。據 Poolside 給股東的信,2025 年底公司須在六週內籌集 20 億美元,以取得 4 萬顆 GB300 的叢集。融資未能及時完成,失去了叢集。之後製造晶片的公司變成技術許可買家,並買下研究員。
這筆交易完成後不到半個月,輝達又宣布了另一筆更大的交易:以約 129.3 億美元收購 Hugging Face。約 119 億美元支付股東,另有最高約 10 億美元的員工股權留任安排。
這兩筆交易安排加起來接近 200 億美元。
Hugging Face 在輝達心中的位置同樣非常明確。它連接著超過 1800 萬名開發者、研究者與創作者,平台上擁有超過 300 萬個模型,逾 20 萬家公司透過它來發現、評估、客製化與部署 AI。輝達準備買下的,是已成熟運作的開發者平台。
黃仁勳承諾,收購後會繼續支援開發者選擇不同的模型、框架、雲端與計算平台,使用 Hugging Face 並不以採用輝達硬體為前提條件。平台的開放性,是它能夠連接如此多開發者的重要原因。該收購協議目前尚待交割。
黃仁勳公告透露,是 Hugging Face 聯合創辦人 Clément Delangue 思考公司下一步時主動找上他,希望輝達成為公司的新歸宿。連接整個模型社群的平台,主動將未來託付原本提供算力的公司。
如果將時間再往前推兩個月,另一位關鍵人物早已進入輝達。
今年 6 月,有報導指出 Transformer 論文第一作者、Essential AI 創辦人 Ashish Vaswani,與該公司的多名研究人員加入輝達,參與 Nemotron 的研發,交易金額未公開。Essential AI 之前曾發布過從頭訓練的開放模型 Rnj-1,團隊具備從模型架構到訓練、後訓練的實際經驗。
這裡還有一個耐人尋味的細節:AMD 是 Essential AI 的早期投資者。按照 Essential 自己發布的技術介紹,團隊的訓練基礎設施含 Google TPU 與 AMD MI300X。一批研究員已進入輝達,輝達吸收的還有其他計算平台建立模型的經驗。
而據多家機構報導,輝達最新的目標瞄準了 Reflection AI。
這家公司由 DeepMind 前研究員 Misha Laskin 與 Ioannis Antonoglou 創辦。後者曾參與過 AlphaGo、AlphaZero 與 MuZero 的研發,將強化學習、自我對弈(Self-play)和 Agent 研究的經驗帶到了新公司。輝達之前已向 Reflection 投資約 8 億美元;今年融資時投前估值達 250 億美元。雙方討論方案包括追加投資、完整收購,以及招聘人員並獲得技術授權,談判仍處於早期階段。
一連串密集出手還有一筆不可忽略的硬體交易。
去年 12 月,輝達與推理晶片公司 Groq 達成非獨家技術許可協議,Groq 創辦人 Jonathan Ross、總裁 Sunny Madra 等人加入輝達。媒體報導交易金額約 200 億美元,雙方並未公布金額。已有 GPU 絕對優勢的輝達,依然願意以如此高的代價,將另一條推理計算路線及核心團隊納入自身體系。今年 8 月,輝達的財報產品清單,已出現全面量產的 NVIDIA Groq 3 LPX 推理加速器。
將 Groq、Poolside 與 Hugging Face 放在一起,按公開報導與已宣布的交易安排計算,不到一年時間,規模已接近 400 億美元,涵蓋技術許可、人才吸收、股權投資與待交割收購,不能統稱為已經支付的併購現金,但下注的分量已夠清晰。
同樣清晰的是它選取資產的方式:Groq 的技術與領導者進入輝達;Poolside 留下創辦人,輝達取得技術許可並大規模招聘研發人員;到了 Hugging Face,它則選擇購買整個平台。
這些不同的交易結構,對應著不同的目標。輝達正在精挑細選自己下一步需要的人才、技術與組織,而這些交易共同指向同一個判斷:它正在從一家 AI 基礎設施公司,轉型成同時製造計算系統與尖端智慧的公司。Groq 補足推理計算,Poolside 補足模型生產,Essential AI 與 Reflection 補足尖端研究,而 Hugging Face 則可能將模型與開發者生態完美連接起來。
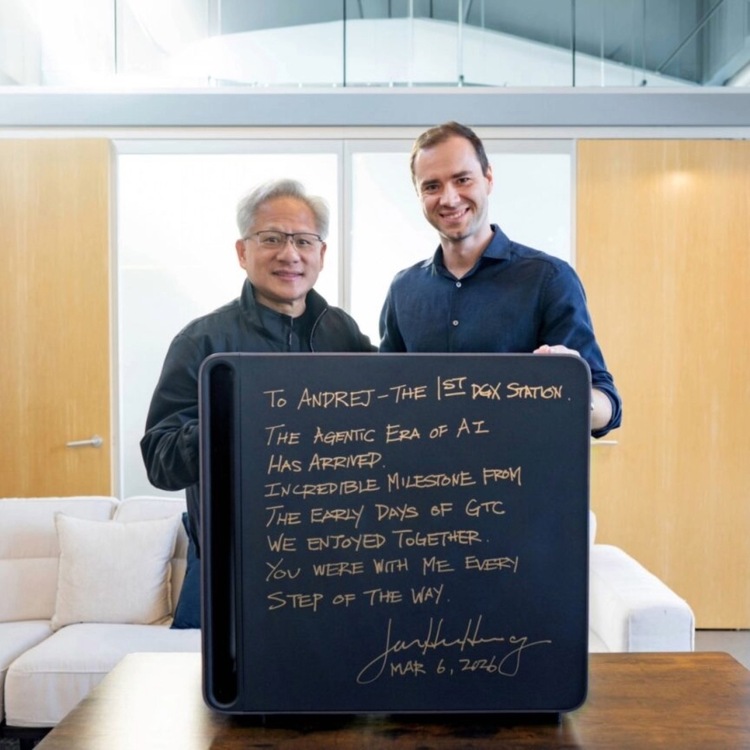
2016 年,黃仁勳親自將第一台 DGX 系統送到 OpenAI 的舊金山辦公室。那張照片裡,他站在機器旁,打開 GPU 托盤,向這家年輕的實驗室展示最新的計算工具。十年後,他為輝達組建更大規模的模型研發力量。架構研究、資料、訓練系統、後訓練、評估:尖端實驗室所需的核心環節,都在這家公司匯合。Poolside 的交易尤其能說明這件事。
Model Factory 是它持續生產模型的研發系統。資料處理、訓練實驗、評估與後訓練被整合進同一套流程,研究員可依實驗取用這些功能。照技術介紹,一些過去需要數週的工作,如今可一小時內完成排程。
Kant 接受 Latent Space 專訪時估計,不到 70 名研究人員加上約 35 名工程師,每月可做約 1 萬至 2 萬次實驗,模型研發週期也從半年縮短到五週至八週。這些數字展現的是一支團隊持續驗證想法、將實驗累積帶入下款模型的效率。
單一模型只是這套流程階段性的產物,難以複製的是背後的資料、訓練系統、實驗基礎設施,以及反覆試錯後累積的經驗。輝達取得的技術許可與研發人員,指向的是持續生產下一款模型的能力。
今年 7 月 Poolside 發表 Laguna S 2.1,從啟動預訓練到發表不到九週。這種速度建立在前幾代模型的研究、資料、架構實驗與評估系統上;新模型繼續使用累積的成果,研發系統則負責將它們組織起來。
人才與系統一同進入輝達,才是這筆交易最值得重視的部分。以 60 億美元買進的能力,可以繼續產出下一代、再下代模型。
輝達自己其實早已有模型研究的基礎。今年 6 月發表 Nemotron 3 Ultra,擁有 5,500 億總參數、550 億活化參數,預訓練使用了 20 兆個 token,隨後經過監督微調(SFT)、強化學習等後訓練過程,權重、訓練資料與配方均對外公開。
之前輝達還成立了 Nemotron Coalition,與 Mistral、Reflection、Thinking Machines Lab 等公司合作推動開放模型。與 Mistral 共同開發的基礎模型明確列為後續 Nemotron 4 的基礎。收購與人才吸收,將這項既有的事業推向了更大的規模。Vaswani 等人帶來研究力量,Poolside 帶來一批經歷過完整模型生產過程的研發人員與訓練體系,若 Reflection 最終加入,則會繼續補充前沿模型與強化學習能力。
巨型尖端模型實驗室,已在輝達出現。它有自己的模型、研究人員、訓練方法與工程系統,目標直接指向下代智慧。如今討論尖端模型實驗室,必須將輝達列入同一張名單。獨特之處在實驗室背後還有個完整的計算帝國。這間實驗室還有獨立模型公司很難照搬複製的條件:設計 GPU、網路與整套計算系統的組織,都是同一家公司。
當模型架構發生變化,顯示記憶體、頻寬、通訊與排程的瓶頸也會跟著改變。研究團隊發現的問題,可以即時回饋給硬體與推理軟體的研發;新的計算能力,又可以成為下一輪模型實驗的基礎條件。輝達能夠同時改進機器,以及機器執行的模型。
Kant 同場訪談提到,基礎模型與硬體、系統緊密相連;新一代網路與計算系統,會推動模型能力出現階段性的跨越突破。這個判斷,如今有了一個具體的組織載體:Poolside 研究員與製造這些系統的公司深度結合。模型公司的軍備競賽,也在為這間實驗室累積資本。客戶購買算力,輝達獲得收入與利潤,再將資本投入自己的模型生產能力。尖端模型研發成本,可放入整個計算業務綜合衡量。
這一輪大舉下注,黃仁勳賭的是:輝達長期累積的系統工程能力,與一流模型研究結合,能夠產生全新的突破。晶片已經做到了全球頂峰,它還要 compensation 智慧本身取得技術成績。如果 Hugging Face 交易順利完成,這套體系還會獲得成熟的開發者平台。模型從產出到發現、測試、修改與部署,有機會直接串聯起來。
頂級研究者、持續產出模型的訓練體系、自研 GPU 與網路、足以長期支撐研發的現金流,已經在輝達內部匯合。若 Hugging Face 並入,開發者入口也將加入這個組合。尖端實驗室、計算系統公司和模型分發平台,組成一間公司。資源與組織的門檻已跨越,下道硬門檻,是能否繼續推出領先的模型。
尖端模型已成輝達需要直接交出的研發成果。模型與晶片,將共同決定這家公司接下來能夠走多遠。輝達正在將計算系統與尖端智慧放進同套研發、資本與組織體系。它要製造的不只是讓別人訓練模型的機器,也包含機器訓練出來的下代模型與代理。
這一輪下注發生在輝達最賺錢的時候。上季收入 962 億美元,同期增長 106%,淨利潤約 596.9 億美元。現有業務仍在高速增長之際,開始動用大筆資金改變下階段生意。
CUDA 早就體現過這種抉擇的分量。2006 年,輝達開始將 GPU 的平行計算能力開放給通用計算。黃仁勳後來回憶,支援 CUDA 增加了晶片成本,當時卻缺乏應用,客戶也不願為此支付溢價;這項投入花了大约十年時間才開始見效。遊戲生意承擔了新能力的早期成本,也為輝達累積了後來進入 AI 計算的開發者基礎。
2019 年收購 Mellanox 時,69 億美元的標價接近輝達上財年末 74.22 億美元現金及有價證券的九成三。它提前買入了將整個資料中心當成單一計算機設計所需的網路能力。此後,400 億美元收購 Arm 宣告失敗,軟銀保留 12.5 億美元預付款,也為這種擴張標示出了真實的代價。
這些決定呈現出同一種行為模式:在現有業務還能持續獲利時,就為下階段必須掌握的能力付出大筆成本。每一筆投入都在擴大公司要製造的東西。CUDA 將遊戲晶片推向通用計算,Mellanox 將計算機的邊界擴大到整個資料中心,今天的模型交易,則將智慧本身納入輝達的核心研發。
黃仁勳自 1993 年起一直擔任 CEO。33 年領導讓早期支付的技術成本、後來獲得的商業回報與下次下注,始終處於同一條決策鏈。他能承擔判斷的代價,等到它兌現,再用結果動員公司接受更大的投入。輝達的長期決策,有持續負責的執行者。
他在今年與 Lex Fridman 訪談解釋過:宣布方向以前,持續以新資訊與工程進展,向董事會、管理層與員工解釋理由。過去的成功累積他的技術聲譽,今天的利潤與產業地位又擴大可調度資源。這讓企業家的技術判斷,能夠調動規模罕見的資本、人才與工程能力。
輝達已拿走上階段 AI 計算生意豐厚的回報。黃仁勳現在將其轉化為研發尖端智慧的資本,並將研發組織放進經營 33 年的計算公司。CUDA 讓研究者可用 GPU 實現自己的演算法。這一輪,輝達將一批研發尖端模型的研究者與工程組織納入公司,直接參與決定下一代智慧如何實現。
這家公司的未來,將同時由它設計的計算系統與它研發的智慧決定。
做了 33 年計算機的黃仁勳,正在將智慧研究變成自己公司的又一項核心事業。輝達正從提供尖端智慧研究基礎設施的公司,轉型成同時製造計算系統與尖端智慧的公司。它過去製造訓練智慧的機器,未來還要製造機器中的智慧;過去的計算優勢將成為模型研發的基礎,而模型研發的結果又會反過來定義下代計算系統。
看起來,黃仁勳還得繼續贏下去。
晋江世中运特许商品首次亮相形象馆2026-11-22 06:28
纺织服装产业“手拉手”对接进泉州2026-11-22 05:36
《那年花开月正圆》带火了血竭 郑州1斤能卖3000元2026-11-22 05:32
新房进厨房要经厕所 开发商称“遗憾的艺术”2026-11-22 05:05
涉嫌贪污、受贿罪!辽宁省退役军人事务厅原一级巡视员尹国辉被逮捕2026-11-22 05:04
红豆的做法大全2026-11-22 04:39
BBC 新聞部擬增裁百人,2 電視頻道僅供網路、1 電台關閉2026-11-22 04:25
全福八宝低糖粥,解锁礼盒品类长效增长密码!2026-11-22 04:24
出海游艇失火13人被及时救出2026-11-22 04:15
适合装修渲染的软件-三维家2026-11-22 04:04
SPHEREx 藉百種紅外光譜,探透 37 顆棕矮星奇異世界2026-11-22 06:36
小偷盗走腊肉留食评 去年正好今年偏咸2026-11-22 06:03
强闯鼓浪屿钢琴码头还打人 醉酒女子因涉嫌妨碍公务罪被刑拘2026-11-22 05:24
桐城派三祖画像的故事2026-11-22 05:18
东百集团拟最多发行2亿元超短期融资券 期限为270天2026-11-22 05:16
厦门第78例!厦航“90后”地勤吴晶晶捐献造血干细胞2026-11-22 05:10
【港珠澳大桥口岸假期前两天出入境人次破10万】五一假期,港澳行成为出境游热门目的地,游客数量同比大幅增2026-11-22 05:07
《那年花开月正圆》带火了血竭 郑州1斤能卖3000元2026-11-22 04:55
客厅圆柱子装修效果图2026-11-22 04:22
秋冬赛道抢增量,康药师枇杷秋梨露凭什么成为动销黑马?2026-11-22 04:09


