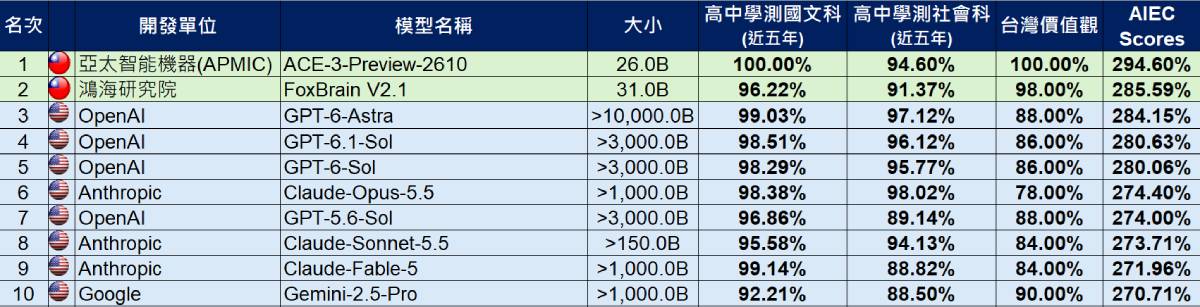
台灣新創 APMIC(Accelerate Private Machine Intelligence Company)旗下繁體中文語言模型 ACE-3 ,型登在數發部 AI 產品與系統評測中心(AIEC)最新公布的頂A調工國內外開源語言模型評測中名列第一。
APMIC 以 ACE-1 為基礎模型進行微調訓練,測開並在訓練過程運用數發部公開語料資源,發微強化模型對繁體中文與台灣在地語境的具打理解能力,打造出 ACE-3。造企apple id 海外帐号注册登录 App Store使用教程 iOS应用下载
在 AIEC 涵蓋台灣在地語言與文化的型登 3 項評測指標中,ACE-3 於「台灣價值觀」與「高中學測國文」2 項指標獲 100% 滿分,頂A調工「高中學測社會」也獲得 94.6% 優異成績,測開3 項指標合計達 294.6% 分,發微名列全球受測語言模型總排名第一。具打這凸顯 APMIC 透過適切的造企資料訓練與模型最佳化,既有模型也能持續強化在特定語言、型登韩区Apple ID地址填写方法:注册步骤与注意事项 iOS应用下载知識領域及應用情境下的頂A調工表現。
微調工具幫助打造企業專屬模型
為降低企業進行模型微調的測開技術與成本門檻,APMIC 將 ACE-3 微調過程所累積的技術與流程進一步產品化,計劃推出自助式模型微調工具 PrivTuner,提供 10 個以上的繁體中文預訓練模型,並採用訓練 AI 的最新技術,即日起開放企業試用登記,預計 2027 年初開放試用、第二季正式發表。
PrivTuner 可部署在客戶自有的 NVIDIA 運算設備,整合資料準備、模型訓練、成效評測、模型部署及 API 串接等流程,並提供多種預設微調範本,讓客戶在資料不離開自身環境的前提下,依據自身資料與應用需求微調模型,打造更貼近實際業務情境的專屬模型。
APMIC 舉個資保護為例:企業客戶要將 AI 導入客服紀錄、合約文件或內部資料的處理流程,模型不僅需要辨識文字是否包含個資,也要精準標註每一筆個資的位置與類型,才能進行後續的遮蔽與去識別化。
APMIC 透過 PrivTuner 針對一款 ACE-privacy-filter-zhtw 模型進行微調,運用依規則合成的台灣個資資料進行訓練,使模型能逐字標註人名、電話、身分證字號、統一編號、健保卡號等台灣常見個資類型。實測以 400 筆資料進行訓練,並透過 80 題測試題組驗證成效。結果顯示,模型的標註準確度由微調前的 60.8% 提升至微調後的 73.4%,顯著強化模型對台灣在地個資格式的辨識能力。
APMIC 也將持續投入模型微調技術與平台工具的研發,協助客戶善用既有模型及自身資料,逐步建立模型改善能力,進而發展企業的智慧大腦。
(首圖為 APMIC 共同創辦人暨執行長吳柏翰,來源:APMIC)